- 5 بهترین کارگزاران و سیستم عامل فارکس با جایزه خوش آمدید در مقایسه
- برای شماره شناسایی کارفرما (EIN) بصورت آنلاین اقدام کنید
- سکه های نادر دیوانگی تغذیه ایجاد می کنند
- آینده شرکت خود را در استراتژی های کوتاه مدت هدر ندهید
- راهنمای بازپرداخت مالیات بر ارزش افزوده برای بازدیدکنندگان اتحادیه اروپا
- Metatrader 5 کارگزاران فارکس
- موسسه خیریه Binance 1000 دانشمند آفریقایی را با همکاری UTIVA اعلام کرد
- آیا Litecoin به 10،000 دلار خواهد رسید؟پیش بینی قیمت Litecoin 2023 ، 2025 و 2030
- عملکرد مدل های مختلف در پیش بینی قیمت سنگ آهن در زمان جهش قیمت کالا
- سرمایه گذاران سیاه و لاتین با ایمان به رمزنگاری مبارزه می کنند
آخرین مطالب
امکانات وب


برایان کافمن
مدیر محصول ، آنتوس
گزارش وضعیت DevOps را تسریع کنید
دیدگاه کاملی از صنعت DevOps کسب کنید و راهنمایی های عملی را برای سازمانها در هر اندازه ارائه دهید.
یادداشت ویرایشگر: روش های زیادی برای پوست گربه DevOps وجود دارد. مهندس برنامه های توسعه دهنده Google Cloud Dina Graves Portman اخیراً در مورد چگونگی ارزیابی اثربخشی DevOps خود با استفاده از پروژه چهار کلید منبع باز نوشت. در اینجا ، برایان کافمن ، مهندس مشتری Google به شما نشان می دهد که چگونه همین کار را انجام دهید ، اما برای برنامه ای که کاملاً در Google Cloud اجرا می شود.
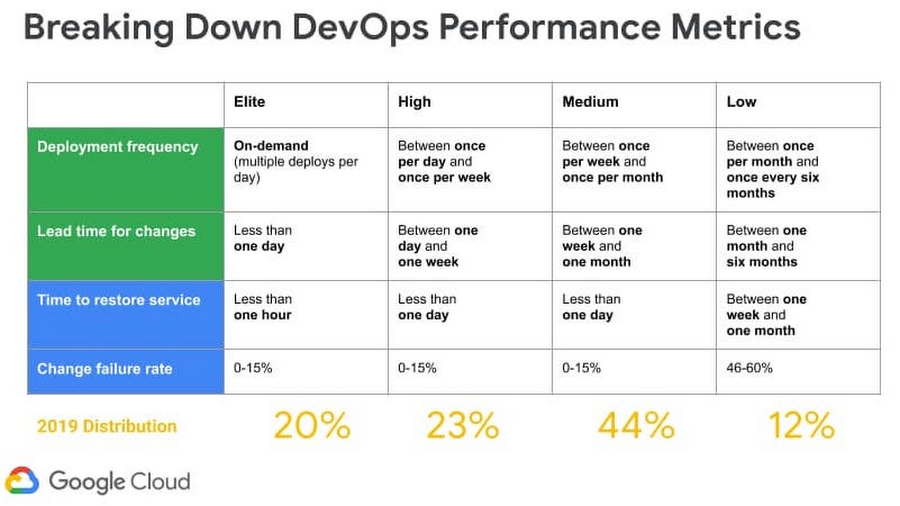
بسیاری از سازمانها آرزو می کنند که مغازه های DevOps با عملکردی با عملکرد بالا باشند ، اما دانستن اینکه در کجا ایستاده اید دشوار است. طبق تحقیقات و ارزیابی DevOps ، یا DORA ، شما می توانید فقط چهار معیار را برای اندازه گیری اثربخشی سازمان DevOps خود در اولویت قرار دهید - دو برای اندازه گیری سرعت و دو مورد برای اندازه گیری ثبات:
1. زمان سرب برای تغییرات - کد متعهد به کد در تولید 2. فرکانس استقرار - چند بار کد را فشار می دهید
3. تغییر نرخ خرابی - نرخ خرابی استقرار در تولید که نیاز به راه حل فوری دارند.(بازگشت یا تغییر دستی) 4. زمان برای بازگرداندن سرویس (MTTR) - میانگین زمان بهبودی.
در این پست ، ما یک روش برای جمع آوری این چهار معیار از خطوط لوله تحویل نرم افزار و برنامه های مستقر در Google Cloud ارائه می دهیم. سپس می توانید از این معیارها استفاده کنید تا اثربخشی کلی خود را ارزیابی کنید ، و عملکرد سازمان خود را در برابر معیارهای صنعت دورا پایه گذاری کنید و تعیین کنید که آیا شما یک مجری نخبه ، بالا ، متوسط یا پایین هستید.
برای بزرگنمایی کلیک کنید
Devops & SRE
2019 Accelerate State of DevOps: عملکرد نخبه ، بهره وری و مقیاس گذاری
Dora و Google Cloud گزارش Accelerate State of DevOps 2019 را منتشر کرده اند.
توسط نیکول فورسگرن • 4 دقیقه خواندن
بیایید نگاهی بیندازیم که چگونه این کار را در عمل انجام دهیم ، با یک معماری نمونه در Google Cloud.
خدمات و معماری مرجع
برای شروع ، ما یک خط لوله CI/CD با خدمات ابری زیر ایجاد می کنیم:
- repo کد GitHub
- Cloud Build ، ابزار CI/CD مبتنی بر کانتینر)
- رجیستری کانتینر
- موتور Google Kubeetes (GKE)
- تعادل بار ابری ، به عنوان یک کنترل کننده ورود برای GKE استفاده می شود)
- بررسی های Uptime Cloud ، برای نظارت بر برنامه های مصنوعی
- نظارت بر ابر
- توابع ابری
- Pub/Sub ، به عنوان یک اتوبوس پیام برای اتصال هشدارها به توابع ابر استفاده می شود)
اینها در معماری مرجع زیر ترکیب شده اند. توجه داشته باشید که همه این سرویس های Google Cloud با نظارت Cloud یکپارچه شده اند. به همین ترتیب ، هیچ چیز خاصی وجود ندارد که شما برای دریافت سیاهههای خدمات نیاز به راه اندازی داشته باشید ، و بسیاری از این سرویس ها معیارهایی ساخته شده اند که ما در این پست از آنها استفاده خواهیم کرد.
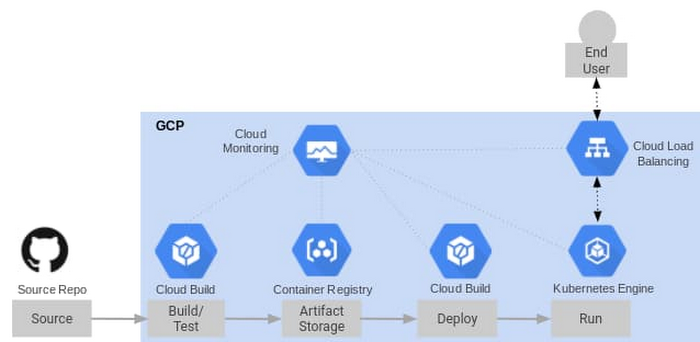
Google Cloud Platform CI/CD خط لوله و توپولوژی برنامه
اندازه گیری سرعت
برای اندازه گیری دو معیارهای سرعت ما - فرکانس اشتغالزایی و زمان سرب برای تعهد - ما ساز ابر ساز ، که یک ادغام مداوم و ابزار تحویل مداوم است. به عنوان یک ابزار CI/CD مبتنی بر کانتینر ، Cloud Build به شما امکان می دهد مجموعه ای از سازندگان ابر مدیریت شده Google یا جامعه را بارگیری کنید تا کد شما را دستکاری کنند یا در طی فرآیند ساخت/استقرار با خدمات داخلی و خارجی ارتباط برقرار کنند. پس از شلیک یک ماشه ساخت ، Cloud Build برای کد منبع ما به مخزن Git ما می رسد ، یک مصنوعات تصویر کانتینر را ایجاد می کند که به رجیستری کانتینر فشار می دهد و سپس تصویر کانتینر را به یک خوشه GKE مستقر می کند.
همچنین می توانید ظرف سازنده ابر خود را در این فرآیند وارد کرده و آن را به عنوان مرحله ساخت نهایی درج کنید تا زمان تعهد به استقرار و همچنین اینکه آیا این استقرار بازپرداخت است ، تعیین کنید. برای این مثال ، ما یک ظرف سفارشی ایجاد کرده ایم که به عنوان آخرین مرحله ساخت استفاده شود که:
- اتصال بار را برای زمانبندی متعهد به متغیر $ (push. repository. pushed_at) بازیابی می کند و آن را در برابر زمان بندی فعلی برای محاسبه زمان سرب مقایسه می کند. متغیر اتصال بار در هنگام ایجاد ماشه استفاده می شود و توسط یک متغیر سفارشی ، $ _merge_time در cloudbould. yaml ارجاع می شود.
- برای به دست آوردن شناسه متعهد آخرین تعهد در شعبه مستر ، به repo منبع می رسد و آن را با شناسه تعهد فعلی ساخت و ساز مقایسه می کند تا مشخص شود که آیا این یک بازگشت یا مسابقه است.
شما می توانید یک پیکربندی Cloud Cloud Build را در اینجا پیدا کنید که هر مرحله ساخت را که در بالا توضیح داده شده است نشان می دهد. اگر از یک متغیر غیر ساخته شده مانند "$ _merge_time" اتصال بار در پرونده پیکربندی خود استفاده می کنید ، هنگام تنظیم ماشه Cloud Build Trigger به مقدار $ (push. repository. pushed_at) باید نقشه متغیر را مشخص کنید.

می توانید ظرف Clust Cloud Builder را که در اینجا استفاده می شود پیدا کنید. بعد از اجرای مرحله برای این ظرف ، موارد زیر به سیاهههای ساختمانی ابر ، که به طور خودکار در نظارت بر ابر تغذیه می شوند ، خروجی می شود. به شناسه تعهد ، ارزش برگشت و مقادیر سرب که از طریق سازنده ابری سفارشی ما نوشته شده است ، توجه کنید:

در مرحله بعد می توانیم یک متریک مبتنی بر ورود به سیستم در ورود به ابر ایجاد کنیم تا این مقادیر سفارشی را جذب کنیم. معیارهای مبتنی بر ورود به سیستم می تواند بر اساس فیلترهای مربوط به ورودی های خاص باشد.
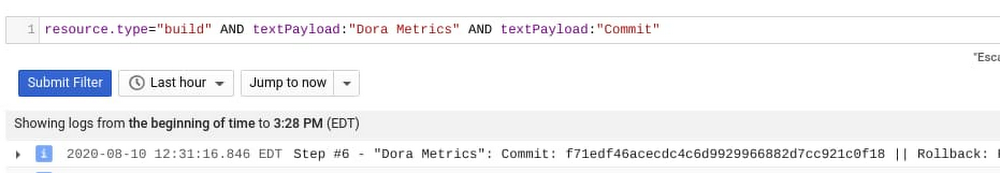
هنگامی که ما فیلتر ورود به سیستم خاص خود را در اختیار داشتیم ، می توانیم از عبارات منظم استفاده کنیم که به یک قطعه خاص از سیاهههای مربوط به خروجی اختصاص داده شده است تا بخش های خاصی از ورود ورود به سیستم را به معیارها ضبط کنیم. در تصاویر زیر ما برچسب هایی را برای نام تعهد و مقدار برگشت بازپرداخت ایجاد کردیم که به مقدار سرب که در قسمت "TextPayload" ورود به سیستم ما نشان داده می شود ، وصل می شود. ما از عبارات منظم زیر استفاده می کنیم:
بارگذاری.
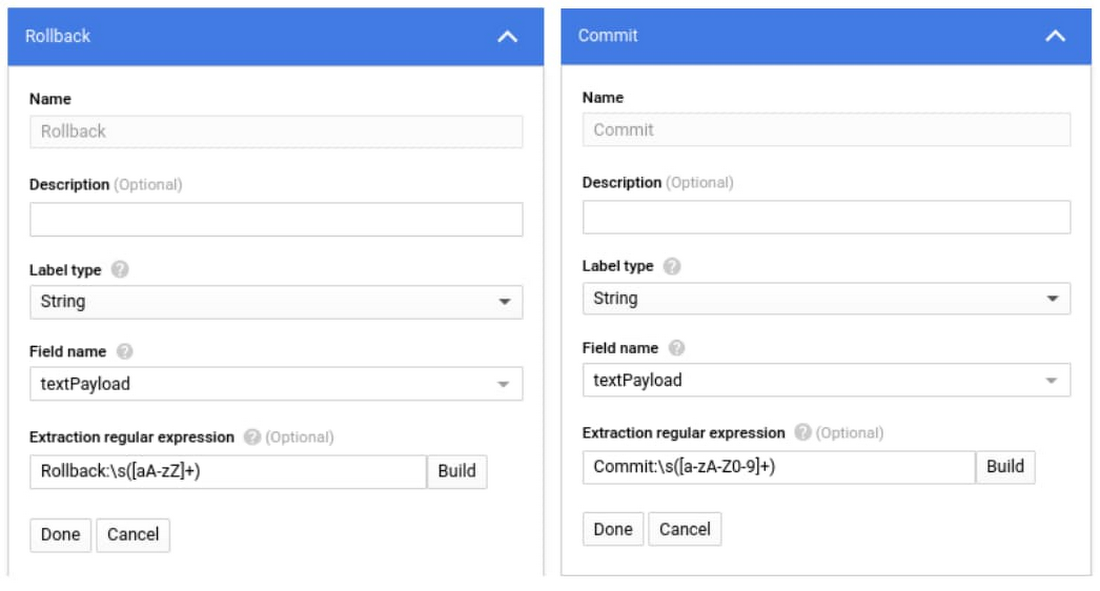
مقدار متریک:
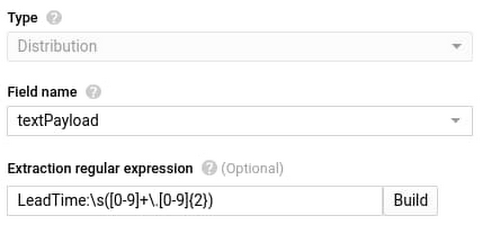
متریک و برچسب های مبتنی بر ورود به سیستم ایجاد کنید
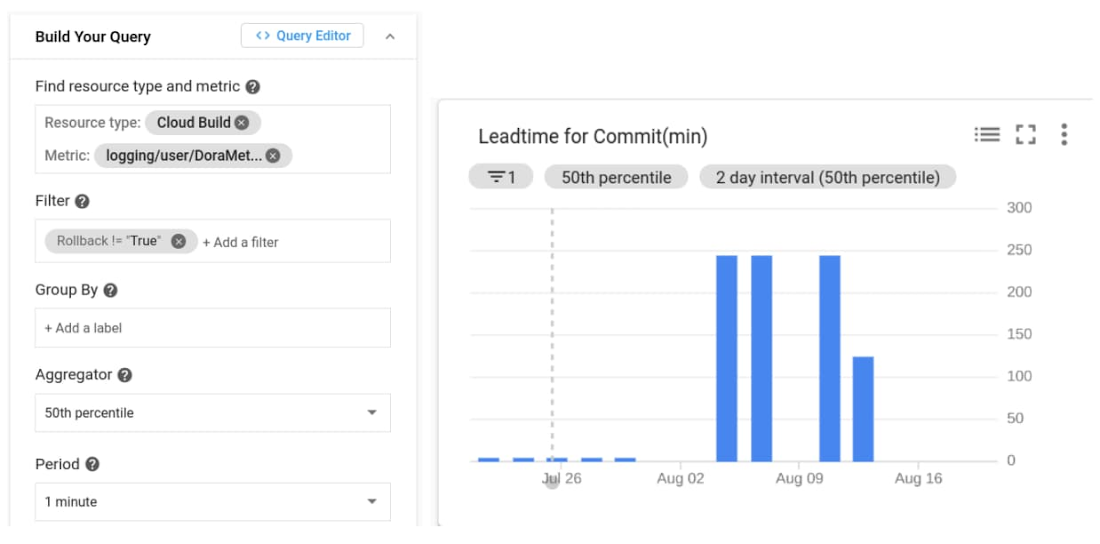
زمان سرب برای تغییرات
هنگامی که ما متریک و برچسب های فوق را از ورود به سیستم Cloud Build ایجاد کردیم ، می توانیم از طریق برچسب متریک "ورود به سیستم/کاربر/Dorametics" به آن دسترسی پیدا کنیم. مقدار متریک زمان سرب خواهد بود که از بیان معمولی در بالا استخراج می شود ، و بازده های آن فیلتر می شوند. ما از صدک متوسط یا 50 استفاده می کنیم.
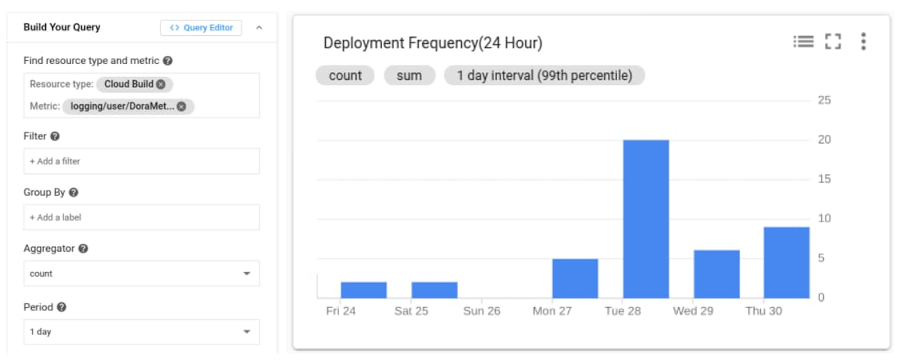
فراوانی استقرار
اکنون که زمان اصلی را برای هر تعهد داریم ، می توانیم با شمارش تعداد زمان سرب که در یک پنجره ضبط کردیم ، فرکانس استقرار را تعیین کنیم!
ثبات اندازه گیری
تغییر عدم موفقیت
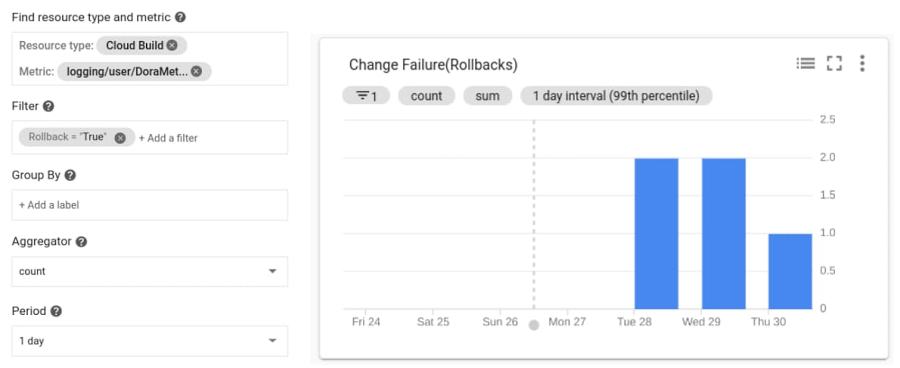
برای تعیین تعداد بازپرداختهای نرم افزاری که انجام شده است ، می توانیم فرکانس استقرار خود را بررسی کنیم و برای معیارهای "Rollback = True" فیلتر کنیم. این به ما تعداد کل برگشت های انجام شده را به ما می دهد. اگر می خواستیم نرخ خرابی تغییر را تعیین کنیم ، از داده های جمع آوری شده در این نمودار استفاده می کنیم و آن را با متریک فرکانس استقرار جمع آوری شده در بالا برای همان پنجره تقسیم می کنیم.
میانگین زمان به وضوح (MTTR)
در محیط های شرکت معمولی سیستم های پاسخ به حادثه وجود دارد که به شما امکان می دهد تعیین کنید که چه زمانی یک مسئله گزارش شده است و چه زمانی در نهایت حل شده است. با فرض اینکه می توان این زمان ها را پرس و جو کرد ، MTTR را می توان با میانگین زمان بین زمان بندی گزارش شده و حل شده از موضوعات تعیین کرد.
در این وبلاگ از اتوماسیون برای هشدار و مشکلات نمودار استفاده می کنیم ، که به ما امکان می دهد معیارهای اختلال در سرویس دقیق تری را جمع آوری کنیم. استراتژی ما شامل استفاده از اهداف سطح خدمات (SLO) است ، که نشانگر شاخص های سطح خدمات (SLI) است که ما تعیین کرده ایم که شادی مشتریان خود را از کاربرد و یک هدف ما نشان می دهد. هنگامی که ما یک SLO را نقض می کنیم ، می دانیم که سرویس میانگین زمان به بازگشت ما کل زمانی است که برای تشخیص ، کاهش و حل یک مشکل لازم است تا زمانی که دوباره مطابق با SLO نباشیم.
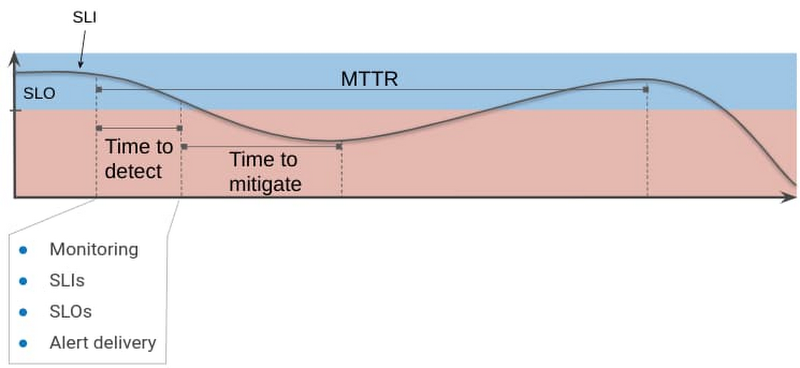
MTTR و رضایت مشتری
برای اهداف سادگی ، ما یک متریک را برجسته کرده ایم که احساس می کنیم رضایت مشتری خود را نشان می دهد: خطاهای کد پاسخ HTTP به طور کلی از وب سایت ما. نسبت این متریک در برابر کل کدهای پاسخ ارسال شده از طریق یک پنجره زمانی معین ، نشانگر سطح خدمات ما (SLI) را تشکیل می دهد.
برای خطاهای کل ، ما کدهای پاسخ را که از بالانسر بار جلوی ما بازگردانده شده است ، که به عنوان یک کنترل کننده Ingress در خوشه GKE ما تنظیم شده است ، نظارت می کنیم.
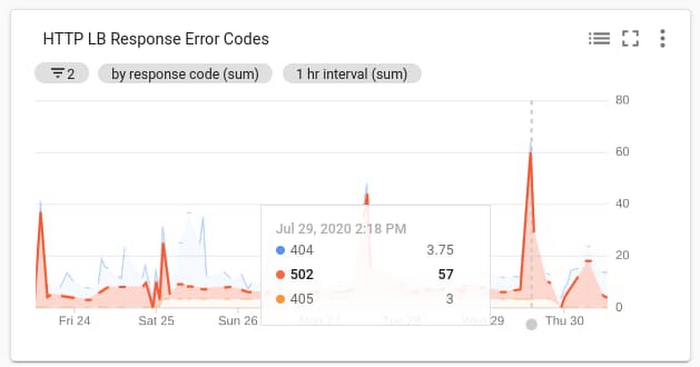
متریک مورد استفاده: LoadBalancing. googleapis. com/https/request_count توسط پاسخ_ code
با استفاده از این متریک در بالا می توانیم SLI خود را بسازیم و آن را به SLO بپیچانیم که نشان دهنده رضایت مشتری مشاهده شده در یک پنجره زمانی طولانی تر است. با استفاده از API SLO ، ما SLO های سفارشی ایجاد می کنیم که نشان دهنده سطح رضایت مشتری است که می خواهیم آن را کنترل کنیم ، جایی که در آن نقض آن SLO نشانگر یک مسئله است. یک آموزش عالی در مورد نحوه ایجاد SLO و خدمات سفارشی در اینجا وجود دارد.
در این مثال ، ما یک سرویس سفارشی ایجاد کرده ایم تا برنامه خود را نشان دهد و SLO برای کدهای پاسخ HTTP LB (کد). این یک کیفیت از سطح خدمات را فرض می کند که در آن 98 ٪ از پاسخ های متعادل بار نباید در یک روز معین خطا باشد. انجام این کار به طور خودکار بودجه خطا 2 ٪ در طی 24 ساعت ایجاد می کند. اکنون ، وقتی صحبت از نظارت برای MTTR می شود ، ما یک متریک (SLI) داریم که به سطح خدمات SLO متصل است که نشان دهنده کیفیت خدمات در یک پنجره معین از زمان است. خرابی SLO در تصویر زیر شبیه سازی شده است:
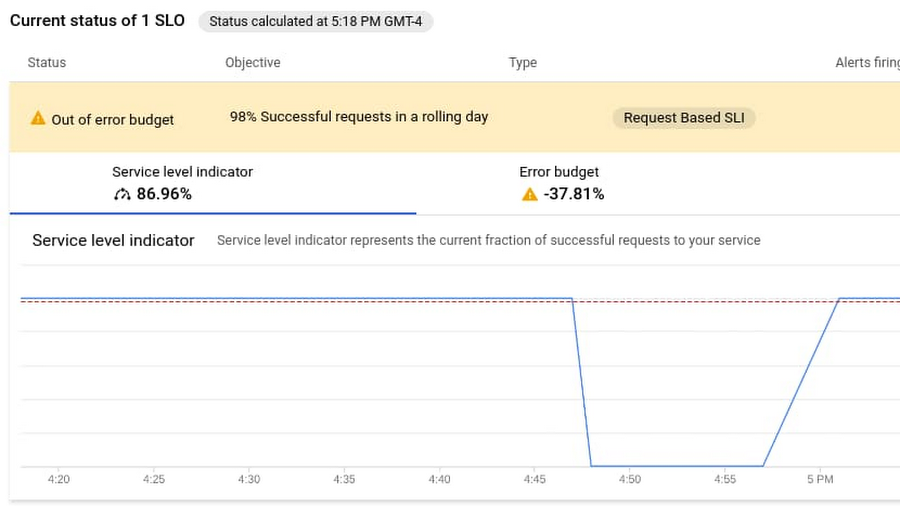
در مرحله بعد ، ما یک سیاست هشدار را تنظیم کردیم که وقتی در معرض خطر نقض این SLO هستیم ، آتش می گیرد. این همچنین یک تایمر را برای محاسبه زمان به وضوح شروع می کند. آنچه ما در اینجا اندازه گیری می کنیم به عنوان "نرخ سوختگی" نامیده می شود - چه مقدار از بودجه خطای ما (2 ٪ از خطاهای طی 24 ساعت) ما با Sli Metic فعلی می خوریم. پنجره ای که ما برای هشدار خود اندازه گیری می کنیم بسیار کوچکتر از کل SLO ما است ، بنابراین وقتی SLI با رعایت آستانه به عقب برگردد ، یکی دیگر از آتش سوزی ها آتش می گیرد و این نشان می دهد که این حادثه پاک شده است. برای اطلاعات بیشتر در مورد تنظیم سیاست های هشدار دهنده ، به این صفحه مراجعه کنید.
همچنین می توانید هشدارهایی را از طریق کانال های مختلف ارسال کنید و به شما امکان می دهد تا در سیستم های بلیط یا پیام رسانی موجود ادغام شوید تا MTTR را به گونه ای ضبط کنید که برای سازمان شما معنی داشته باشد. برای اهداف ما با کانال اتوبوس Pub/Sub Message ادغام می شویم و هشدارها را به یک عملکرد ابر ارسال می کنیم که ماشین حساب های نمودار لازم را انجام می دهد.
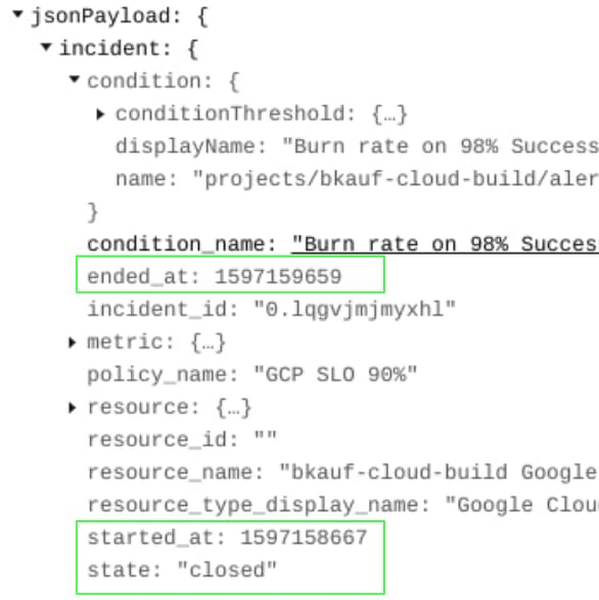
در پیام از هشدار پاکسازی ، می بینیم که بار json دارای زمان بندی start_at و پایان یافته است. ما برای محاسبه زمان برای حل مسئله و سپس خروجی آن به سیاههها ، از این جدول زمانی استفاده می کنیم.
در اینجا کل پیام میخانه/Sub ارسال شده به توابع ابر:
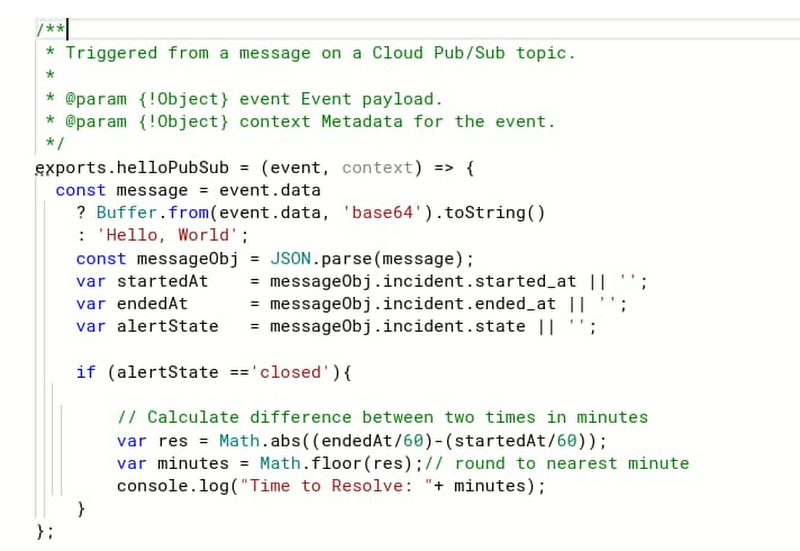
در اینجا تابع ابر متصل به همان میخانه/موضوع فرعی به عنوان هشدار است:
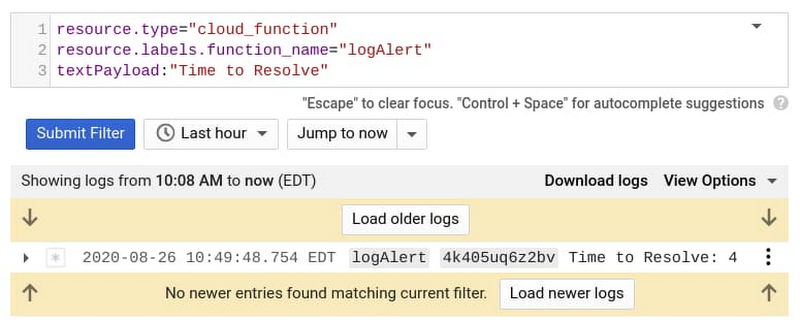
نتایج موجود در پیام های زیر که به توابع Cloud ارسال شده است:
مرحله آخر ایجاد یک متریک مبتنی بر ورود به سیستم برای انتخاب مقدار "زمان برای حل" است که ما برای ورود به سیستم توابع ابر خود چاپ می کنیم. ما این کار را با این بیان Regex انجام می دهیم
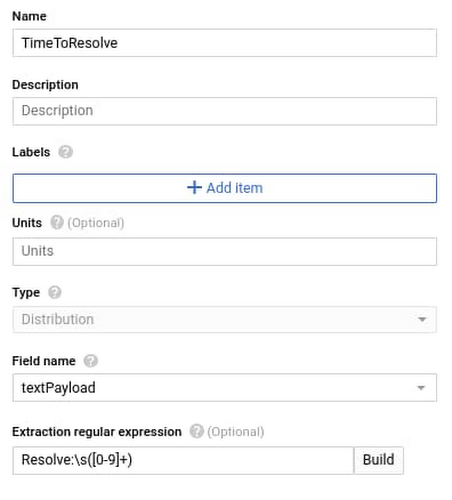
اکنون این متریک در عملیات ابری موجود است.
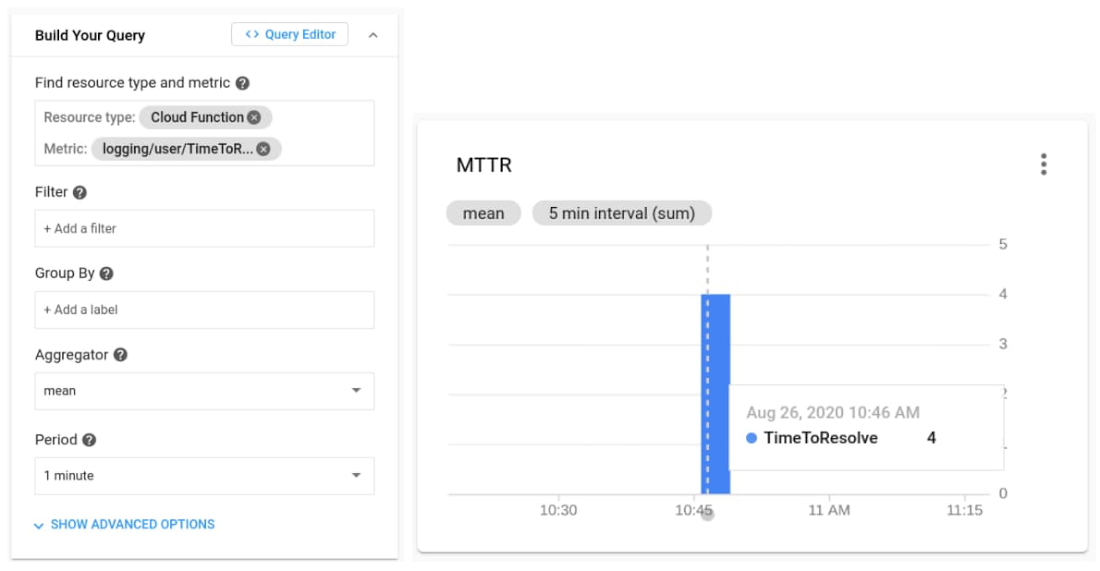
ما در بالا نشان داده ایم که چگونه می توانید سازندگان ابری سفارشی را در ساخت ابر ایجاد کنید تا معیارهای مربوط به فرکانس استقرار ، میانگین زمان به استقرار و بازپرداخت را ایجاد کنید که در سیاهههای مربوط به عملیات ابری ظاهر می شود. ما همچنین به شما نشان داده ایم که چگونه می توانید از SLO و SLIS برای تولید و فشار دادن هشدارها به سیاهههای توابع ابر خود استفاده کنید. ما از معیارهای مبتنی بر ورود به سیستم استفاده کرده ایم تا معیارهای خود را از سیاههها بیرون بیاوریم و آنها را ترسیم کنیم. از این معیارها می توان برای ارزیابی اثربخشی خطوط لوله توسعه نرم افزار و تحویل نرم افزار سازمان شما در طول زمان استفاده کرد و همچنین به شما در ارزیابی عملکرد خود در بین جامعه DevOps بیشتر کمک می کند. سازمان شما به کجا می رسد؟
برای الهام بیشتر ، در اینجا برخی از مواد مرجع دیگر برای کمک به شما در اندازه گیری اثربخشی سازمان DevOps خود به شما کمک می کند:
- برنامه نوسازی برنامه Google Cloud (وبلاگ)
- تنظیم SLOS: راهنمای گام به گام (وبلاگ)
- تنظیم SLO: مشاهده با استفاده از معیارهای سفارشی (وبلاگ)
- مفاهیم در نظارت بر خدمات (مستندات)
- کار با SLO API (مستندات)
- نحوه ایجاد SLO در کنسول GCP (فیلم)
- نحوه ایجاد SLO در مقیاس با SLO API (فیلم)
- نحوه ایجاد SLO با استفاده از معیارهای سفارشی (فیلم)
- کد API Github SLO که برای وبلاگ استفاده می شود
- بررسی سریع دورا
- پروژه 4 کلید برای متریک دورا به BigQuery
- 21 روش جدید ما در حال بهبود مشاهده با Cloud Ops (وبلاگ) هستیم
Devops & SRE
آیا شما یک مجری Elite DevOps هستید؟با پروژه چهار کلید پیدا کنید
بیاموزید که چگونه پروژه منبع باز چهار کلید به شما امکان می دهد عملکرد DevOps خود را مطابق با معیارهای دورا ارزیابی کنید.
توسط دینا گریوز پورتمن • 6 دقیقه خواندن
- Devops & SRE
- ابر گوگل
- عملیات ابری < Pan> تنظیم SLO: مشاهده با استفاده از معیارهای سفارشی (وبلاگ)

ما را در سایت کسب درآمد از بیت کوین دنبال می کنید
برچسب :
نویسنده : ماهور الوند
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
